Bagi pengguna layanan asisten kecerdasan buatan (AI) berbayar seperti ChatGPT Plus atau Claude Pro, memproses baris kode (coding) yang panjang atau dokumen bertumpuk umumnya berjalan mulus karena dukungan context window yang besar. Namun, bagaimana jika Anda mengandalkan AI versi standar yang tersedia secara gratis?
Permasalahan utama pada AI versi gratis adalah keterbatasan memori jangka pendek (context drift). Alih-alih memperbaiki atau menganalisis source code secara komprehensif, AI sering kali ‘linglung’ atau mengalami amnesia digital jika teks dikirim secara bertahap dalam beberapa bagian (Part 1, Part 2, dst.). AI cenderung melupakan instruksi atau baris kode awal dan hanya berfokus pada balasan paling akhir.
Mengapa AI Gratisan Sering Lupa Konteks?
Secara teknis, model bahasa besar (LLM) bekerja dengan menghitung bobot token (potongan kata/karakter). Ketika jumlah token melebihi batas context window pada versi gratis, AI akan memangkas informasi dari pesan-pesan awal. Akibatnya, keterkaitan antar-bagian kode menjadi terputus.
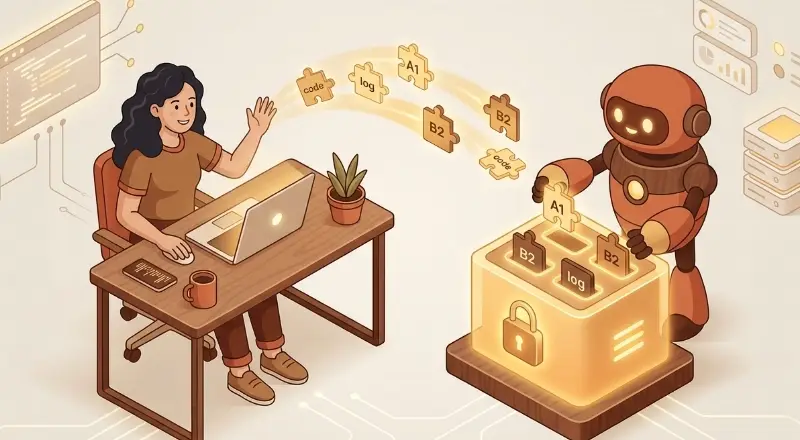
Untuk mengatasi kendala ini tanpa perlu berlangganan versi berbayar, Anda bisa menerapkan teknik Context Locking sederhana via prompt engineering agar AI mempertahankan seluruh bagian teks di memori kerjanya sebelum melakukan analisis.
Langkah-Langkah Mengunci Obrolan AI
1. Tetapkan Kata Kunci (Identifier) Obrolan
Jangan langsung menyuruh AI menganalisis kode yang panjang di awal instruksi. Langkah pertama adalah mendefinisikan aturan main dan keyword khusus.
Contoh Prompt: “Saya akan mengirimkan kode program yang panjang secara bertahap. Mulai saat ini, kita kunci sesi obrolan ini dengan kata kunci [PROJECT-ALPHA]. Setiap kali saya mengirimkan teks dengan kata kunci tersebut, simpan pesan tersebut ke dalam memori sesi tanpa melakukan analisis terlebih dahulu. Cukup konfirmasi dengan membalas: ‘Konteks [PROJECT-ALPHA] tersimpan.’ Apakah kamu mengerti?”
2. Gunakan Mode ‘Simpan Tanpa Analisis’
Ketika Anda membagi source code menjadi Part 1, Part 2, Part 3, AI gratisan kerap membuang pemrosesan untuk memberikan jawaban prematur pada tiap part. Ini memboroskan batas token.
Perintahkan AI untuk hanya menyimpan potongan kode ke dalam memori tanpa berpikir keras mencerna logika fungsinya terlebih dahulu.
Contoh Prompt Kiriman Kode: “[PROJECT-ALPHA] - Part 1 dari 3: [Tempelkan potongan kode bagian pertama di sini] Instruksi: Simpan potongan ini dan jangan dianalisis dulu.”
Hal ini membuat large language model berfokus menyimpan struktur variabel dan fungsi ke dalam memori tanpa terbebani tugas pemrosesan logic yang rumit.
3. Eksekusi Analisis dan Verifikasi Memori
Setelah seluruh part kode selesai dikirimkan, lakukan verifikasi sebelum memberikan perintah eksekusi utama.
Contoh Prompt Eksekusi: “Apakah seluruh bagian kode dengan kata kunci [PROJECT-ALPHA] dari Part 1 sampai Part 3 sudah tersimpan dengan rapi di memorimu? Jika ya, tolong sebutkan ringkasan fungsi utama dari tiap part, lalu perbaiki bug pada baris fungsi X.”
Dengan menyertakan kata kunci utama pada tahap eksekusi, AI dipaksa memanggil ulang seluruh array data yang ditandai kata kunci tersebut dalam sesi obrolan. Hasilnya, respons AI akan tetap akurat, konsisten, dan bebas dari amnesia konteks.
Komentar